Dalle GPU da gaming agli acceleratori AI
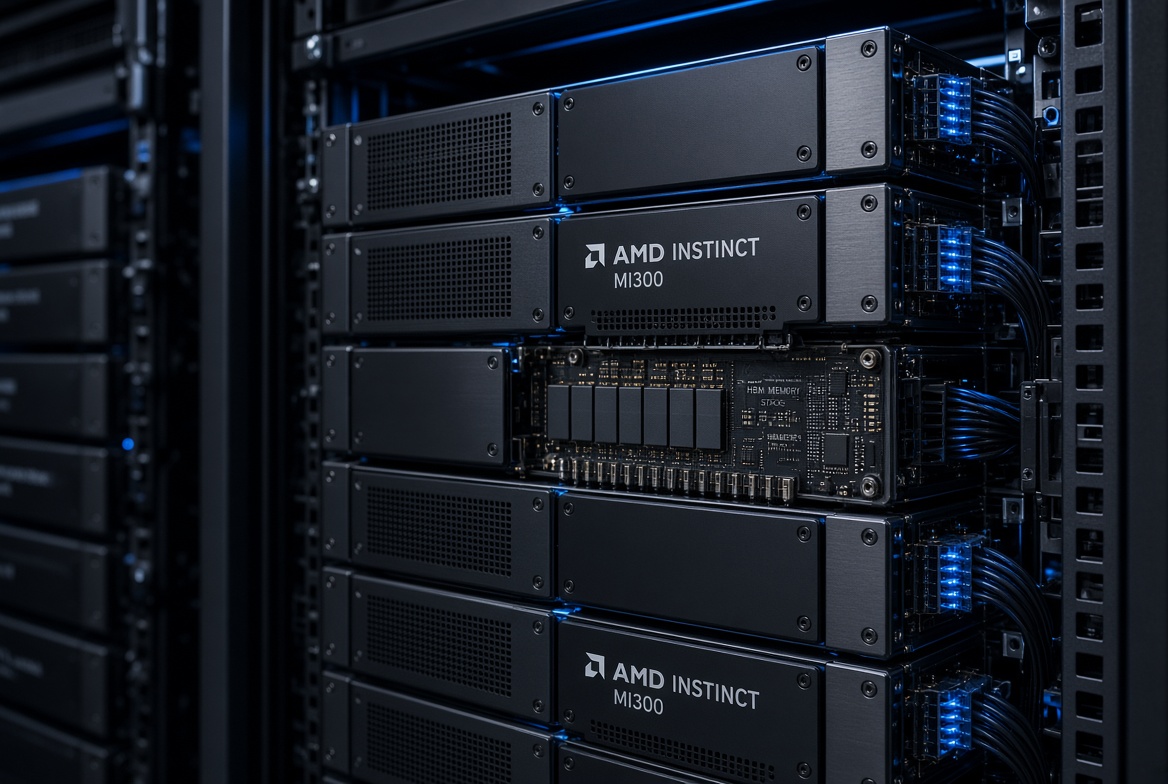
AMD è partita come rivale di Nvidia nel settore delle schede grafiche consumer. Nei data center, però, ha compiuto un’evoluzione rapida. La serie Instinct, basata sull’architettura CDNA, è stata progettata specificamente per il calcolo ad alte prestazioni e per l’AI. Il prodotto di punta è l’MI300X, un acceleratore con fino a 192 GB di memoria HBM3 e una larghezza di banda di circa 5,3 TB/s. Queste caratteristiche gli conferiscono un chiaro vantaggio sui modelli molto grandi che richiedono molta memoria su un singolo GPU.
Confronto diretto: MI300X vs Nvidia H100
| Criterio | AMD MI300X | Nvidia H100 | Vantaggio |
|---|---|---|---|
| Memoria | fino a 192 GB | 80 GB | MI300X |
| Larghezza di banda | ~5,3 TB/s | ~3,35 TB/s | MI300X |
| Ecosistema software | ROCm | CUDA (molto maturo) | H100 |
| Prestazioni training | Competitive | Molto ottimizzate | H100 |
| Prezzo / disponibilità | Più competitivo | Più costoso | MI300X |
L’H100 rimane superiore sulla maggior parte dei carichi di lavoro di training standard, soprattutto grazie alla maturità dell’ecosistema CUDA. L’MI300X vince invece sulla capacità di memoria e sugli scenari in cui il modello non entra in un singolo GPU Nvidia, riducendo la necessità di sharding aggressivo.
Software e adozione
Il punto debole storico di AMD resta il software. ROCm ha fatto grandi progressi ed è oggi compatibile con i principali framework (PyTorch in primis), ma CUDA continua a offrire un’esperienza più stabile e performante “out of the box”. Molte aziende scelgono comunque AMD quando cercano alternative di prezzo o quando hanno bisogno di più memoria per GPU.
In short
AMD è oggi un challenger credibile e concreto. Non ha ancora superato Nvidia, ma con l’MI300X ha dimostrato di poter competere su specifiche chiave come memoria e bandwidth. Il successo futuro dipenderà dalla capacità di ridurre ulteriormente il divario software e di mantenere una buona disponibilità di prodotto.